泰州网络公司 浏览次数:0 发布时间:2026-10-14
老板在豆包、DeepSeek 或文心一言里搜自己的公司,跳出来的回答里夹着一条差评、一桩旧诉讼甚至一句难听的评价,第一反应往往是慌:是不是有人在黑我?要不要赶紧删帖、投诉、压负面?
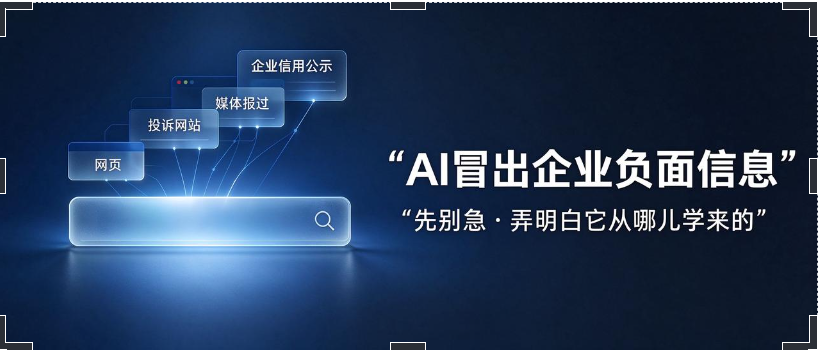
先别急。在花钱压负面之前,最该做的一件事,是先弄明白这条负面信息,AI 到底是从哪儿学来的。因为答案的来源不同,对策完全不同。
01 AI 是怎么“知道”你公司的?
主流 AI 回答企业问题,靠的是两层机制。
第一层是训练语料沉淀。大模型在预训练阶段“读”过海量网页,构成了它对一个品牌的基础印象。这部分更新慢,往往以月甚至年计。
第二层是联网实时检索,行业里叫 RAG(检索增强生成)。你在豆包、DeepSeek 的搜索框里问一句,它会先去网上实时抓取相关信息,再综合生成回答。这意味着,哪怕是一条在网页搜索里排名很靠后的旧新闻或投诉,只要还能被检索到、还相关,就可能被 AI 引用。
所以 AI 几乎不“凭空造”你的信息——它是学来的。这条负面,一定有一个或多个可见的出处。
02 负面信息通常从哪来?
把出处摊开看,常见的有这么几类:
客观事实类。工商处罚、经营异常、欠税、涉诉裁判文书等,来自企业信用信息公示、裁判文书网这类公开平台,属于“有据可查”。
主观口碑类。投诉平台、问答、贴吧、招聘平台上的差评和吐槽,来自真实用户或离职员工的评价,往往情绪化、片面。
陈旧过时类。早年的一起纠纷、一桩早已了结的案件,被 AI 反复引用,成了“陈年旧账”。
平台聚合类。企查查、天眼查这类平台自动生成的工商数据条目,本身是机器整理的,有时口径滞后或不准。
拼接失实类。大模型把多个来源的信息拼在一起,可能拼错、断章取义,甚至出现幻觉——这是需要警惕的一类,因为它“看起来像真的”却未必真。
03 不同来源,对策完全不同
先判断来源,再决定动作,这是关键。
事实类负面,靠“删”没用,得靠整改和公示消除——把处罚处理掉、把经营异常移出,源头清了,AI 自然改口。
口碑类负面,越压越糟。更有效的是经营真实口碑、在正面平台沉淀好评,同时用大量正面内容稀释它在回答里的权重。
陈旧类负面,靠“更新”。已解决的纠纷、已注销的条目,去相应平台申请更新或纠错,别让它一直“挂”在那里。
平台聚合类,走“纠错”。企查查、天眼查这类都有信息纠正渠道,带着证据去申请。
拼接失实类,难也危险。它说明 AI 的可信信源里你的正面信息太稀薄,需要系统性地重建。
一句话:别和 AI 较劲,去找它背后的那些“出处”逐一处理。
04 治本:让 AI 学到“你希望它学的”
负面处理是“止血”,真正治本的是让 AI 的答案来源里,你的正面信息占绝对优势。
这就是生成式引擎优化(GEO)要解决的问题:AI 时代,品牌被看见的方式,正在从“排名”变成“被引用”。
把官网做成“权威的信源”。发展历程、资质、产品参数、案例,结构清晰、事实可查,让 AI 一眼能读懂、敢引用。
多源交叉验证。在权威媒体、行业平台、官方账号多处发布口径一致的正面信息,形成 AI 可以交叉印证的“信任环”。
主动更新陈旧信息。凡是已经解决的旧问题,用新事实去覆盖它。
别放过任何一次被提问的机会。你在问答平台、评论区里每一次正面、专业的回答,都在给 AI 提供“素材”。
说到底,AI 学到什么,取决于你给它的信息环境里有什么。与其盯着一条负面焦虑,不如把正面信息铺到位——这是更省力、也更长效的打法。
老板们,下次在 AI 里看到自家负面,先记住这句话:它从哪儿学来的?找到出处,分类应对,再把正面阵地铺满。负面不会一夜消失,但当你成为 AI 可靠的信息源时,它会越来越少地被“想起来”。